В интернете опубликованы сообщения о масштабных массивах персональных данных, которые распространяются в виде текстовых файлов объёмом в несколько гигабайт. Авторы называют их новыми клиентскими базами и указывают на наличие миллионов записей.
Однако фактический масштаб подобных публикаций определяется не только количеством строк. В крупных архивах могут присутствовать повторяющиеся сведения, устаревшие контакты и записи, полученные из различных источников.
Одна из распространённых практик заключается в объединении нескольких ранее появившихся баз. В результате формируется новый файл, который внешне выглядит как самостоятельная масштабная утечка, хотя значительная часть содержащейся в нём информации уже распространялась раньше.
Дополнительную сложность создаёт отсутствие единых форматов хранения. В одних файлах используются только контактные сведения, в других присутствуют расширенные анкеты, а третьи содержат записи с неполными или повреждёнными данными.
Поэтому заявленное количество строк не позволяет автоматически определить число уникальных пользователей. Для объективной оценки необходимо исследовать структуру архива, установить наличие повторов и определить предполагаемый период формирования записей.
Отдельного внимания заслуживают способы распространения массивов. Архивы часто публикуются несколькими частями, каждая из которых сопровождается отдельным сообщением. Такой подход позволяет длительное время поддерживать интерес аудитории к одной теме.
При этом распространители могут представлять старые данные как новые, используя изменённые названия файлов или повторную упаковку архивов. Без анализа исходного содержимого установить происхождение информации затруднительно.
Для граждан даже устаревшие сведения сохраняют определённую опасность. Старые телефонные номера, адреса и документы могут использоваться для поиска дополнительных данных либо подготовки мошеннических сообщений.
Финансовые организации сталкиваются с необходимостью анализировать подобные публикации, даже когда отсутствуют признаки прямого доступа к их внутренним системам. Само упоминание клиентов компании создаёт вопросы о безопасности обработки персональной информации.
Таким образом, главная проблема крупных архивов заключается не только в их предполагаемом объёме. Существенное значение имеют происхождение сведений, их актуальность и возможность дальнейшего незаконного использования.
 11:30
Вторник
0
13
"Яндекс" раскрыл состояние суперкомпьютеров после атак на дата-центры
Фото: Мария Лихачева / Ruposters Суперкомпьютеры "Яндекса" — "Ляпунов", "Галушкин" и "Червоненкис" — не пострадали в ходе атак на центры обработки данных
 11:30
Суббота
17
Самая черная ночь украинской Единой энергосети: Прилетели злые русские «Герани» и отключили страну от розетки - «Военные действия»
Бандеровцы кроют матом американцев и лично президента Трампа, который посмел притормозить
 11:30
Суббота
31
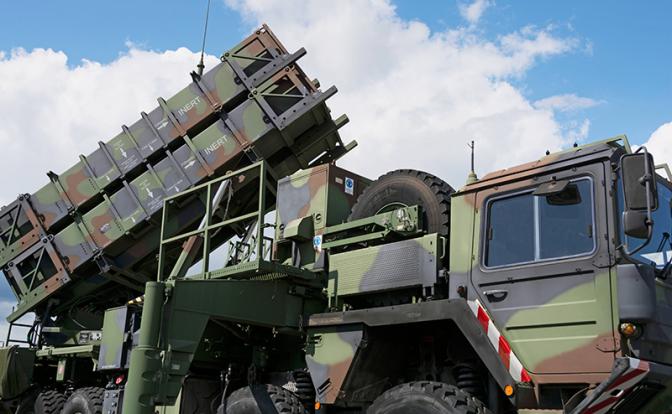
Противоракета PAC-3 Edge: «Мы создали щит от вчерашнего российского гиперзвука!» - «Военные действия»
Очередная сенсация от «Lockheed Martin Corporation» снова опоздала с рождением
 11:30
Вторник
8
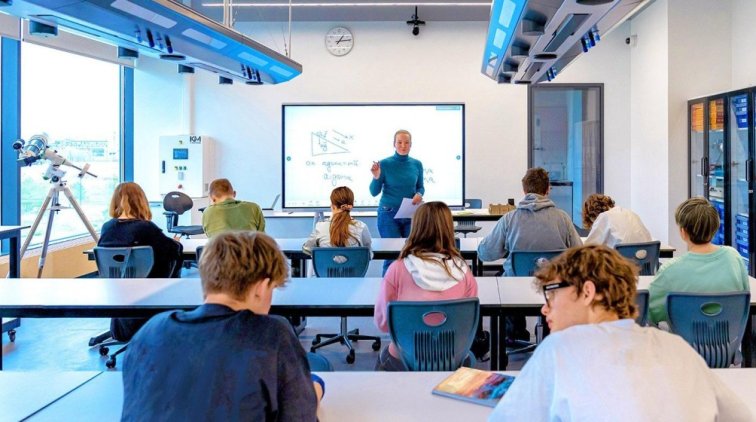
Собянин: сервисы "МЭШ" совершенствуют для персонализированной помощи школьникам
 Происшествия и криминал
11:30
Четверг
0
5
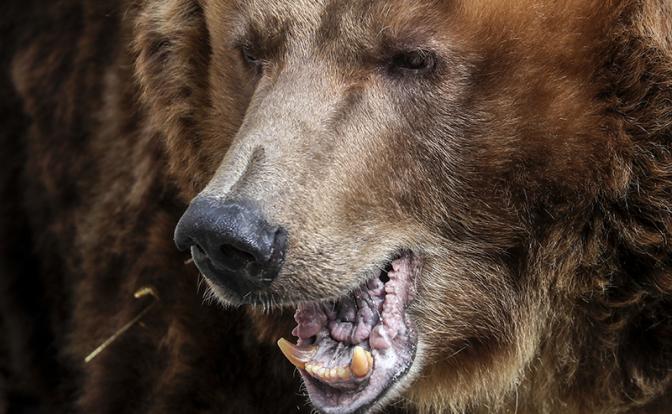
Охота на людей: «В какой бы лес вы сейчас ни шли — лучше иметь при себе заряженное ружье» - «Происшествия»
Из-за «восстания медведей» в стране впору вводить режим ЧС, в Сибири на одного егеря до 100 косолапых